在人工智能生成内容(AIGC)浪潮席卷全球的今天,数据中心作为算力基座,其稳定运行已成为企业数字化转型的生命线。作为数据中心运维工程师,我深知服务器机房不仅是硬件的堆砌,更是承载关键业务逻辑与海量数据的精密生态系统。本文将从独家视角,剖析机房巡检与信息系统运行维护服务在AIGC环境下的核心实践与前沿思考,为同行提供参考。
一、高频次、多维度的机房巡检体系
机房巡检是运维工作的第一道防线。在AIGC业务对延迟和吞吐量要求极高的场景下,我们建立了「日检+周检+月检+专项检」的四级巡检制度。
- 环境巡检团队:每日定时检查机房温湿度、漏水、UPS电池状态、精密空调运行参数,确保PUE值处于理想区间。AIGC服务器集群功耗波动大,我们增加了动态环境监测点,实时预警局部热点。
- 硬件巡检组:每周对服务器、存储、网络设备进行指示灯、风扇、电源、RAID卡落盘状态的物理检查,并结合带外管理(如IPMI/iDRAC)获取硬件健康日志。独家经验:对GPU服务器加强PCIe链路误码统计与NVLink带宽监控,提前发现隐患。
- 系统巡检任务:每日通过自动化平台采集CPU、内存、磁盘I/O、网络流量等性能指标,设置智能基线告警。针对AIGC训练任务,我们开发了基于AI的异常检测模型,能够识别非典型资源占用模式。
- 专项深度巡检:每月执行固件与驱动一致性检查、链路冗余切换测试、备份完整性验证。在重大AIGC项目上线前,增加72小时压测巡检,确保零故障交付。
二、信息系统运行维护服务的核心能力
运维工程师的角色正从「救火队员」向「稳定性架构师」转型。我们的运维服务涵盖:
- 变更管理:所有系统变更遵循严格的申请、评审、实施、验证流程,依托CMDB实现配置项关联影响分析,降低AIGC集群升级风险。
- 容量预测:利用时序数据库和机器学习算法,预测存储与算力增长趋势,提前三个月规划资源扩充,避免AIGC数据集激增导致的瓶颈。
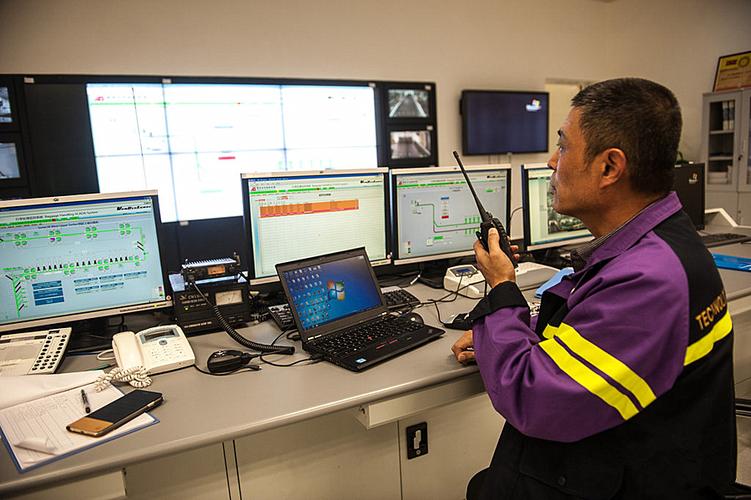
- 应急响应:制定分级应急预案(P1-P4),定期开展故障演练,包括GPU掉卡、IB网络闪断、存储双活失效等AIGC特有场景。值班团队实行7x24小时三级响应机制,MTTR控制在15分钟以内。
- 日志与可观测性:建设统一日志平台和分布式追踪系统,覆盖从训练框架到硬件底层的全栈监控,实现请求级问题定位。
三、独家实践:AIGC驱动的智能运维探索
我们在行业内率先将AIGC技术反向应用于运维自身。例如,使用大语言模型解析运维工单与知识库,自动生成故障排查建议;训练视觉模型识别机房监控图像中的异常状态(如面板告警);构建基于日志大数据的根因分析助手,将复杂问题定位时间缩短60%。独家经验表明,AIGC不仅是被运维的对象,更是提升运维效率的得力工具。
四、与展望
数据中心运维工程师是无声的守护者,我们以系统化的巡检与主动化的维护,保障AIGC浪潮下的数字基础设施坚如磐石。我们将持续融合智能化手段,推动运维服务从「人工经验驱动」向「数据与算法驱动」演进,让机房每一声风扇的转动都有章可循。